我还是想横向比较一下
任务背景:一个服务区跨境电商海外仓的 WMS 系统,里面有个没做完的 AI 助手功能,只有个骨架,而且当前是隐藏、未开启的状态。
两边给了完全一样的提示词:
GWMS系统中,也有一个基于操作手册作为RAG的智能助手,最近GWMS的文档逐渐完善和丰富起来了,我想看看这个AI助手是什么情况,想要对它进行完善和更新。虽然起点相同,但中间的过程有明显差异。
DeepSeek Harness 更像一个架构师,上来就厘清了全局状况,直接给出了下面的结论:
我的完善方案(按优先级)

1. 打通「gwms-doc → 知识库」自动同步(核心,直接对应你的诉求):新增批量入库能力,把 230 个操作手册 markdown 原生化入库(比现在 Tika 解析 PDF/Word 更适合 markdown),并在 gwms-doc 的 CI/GitOps 里加「文档变更 → 触发重建索引」的钩子。

2. 修掉上面的 Bug:重写 reindex(存原始内容/用内容重建)、修 clearChat 文案与序列化、修重复上传端点、修 removeDocumentById 的 Redis 删除、补齐生产 langchain4j 配置。

3. 让设置/历史真正生效:模型选择接到后端、回读会话历史、快捷操作真正发问。

4. 上线启用:打开功能开关、配好生产 Gemini 密钥、端到端验证。
Claude Code CLI 更注重细节:
一句话结论
代码完整保留、后端仍在编译和部署中,只是前端 UI 入口被一个编译期开关关掉了。功能停在 2025-08 的 Beta 状态,2025-11 加了开关后再无实质改动。

...

建议

如果打算彻底废弃:至少把 gwms-ai-assistant 从 gwms-modules/pom.xml 和 gwms-admin/pom.xml 摘掉,让接口不再暴露;并轮换那两个 key。

如果打算重启:优先级应该是 ①轮换 key + 改用环境变量 → ②补 @SaCheckPermission → ③把建表 SQL 纳入 liquibase → ④补 prod/test 的 langchain4j 配置 → ⑤验证 RAG 检索链路 → ⑥最后才是补那几个 TODO。前端只要改 .env 一行 + 重新构建就能亮出来。

要不要我把这份分析整理成一份可分享的报告页面?或者先针对上面某一项(比如权限校验或 key 轮换)动手?
两边都是全新的会话。我还特意在 Claude Code CLI 里执行了 /clear。Claude 一开始并没有提到 gwms-doc 这个仓库的存在,也没意识到这个仓库里其实装着全部的操作手册——而想要启用这个不完善的 AI 助手,显然得从 gwms-doc 入手、在这里下功夫。
再往后,两边的对话就没法对齐了,但最终两边都跑了起来,也完成了我提的要求:一个跑在 80 端口,一个跑在 81 端口;从 dev 环境 dump 出数据库,在本地 MySQL 里分别重建了 gwms_dsh 和 gwms_claude;各自设了自己的版本号,避免 Maven 冲突、互相踩踏;还各自起了独立的 Redis 实例,做到 Redis 向量库的数据隔离。
最终成果
问题一:如何新增客户?
DeepSeek Harness 实现:
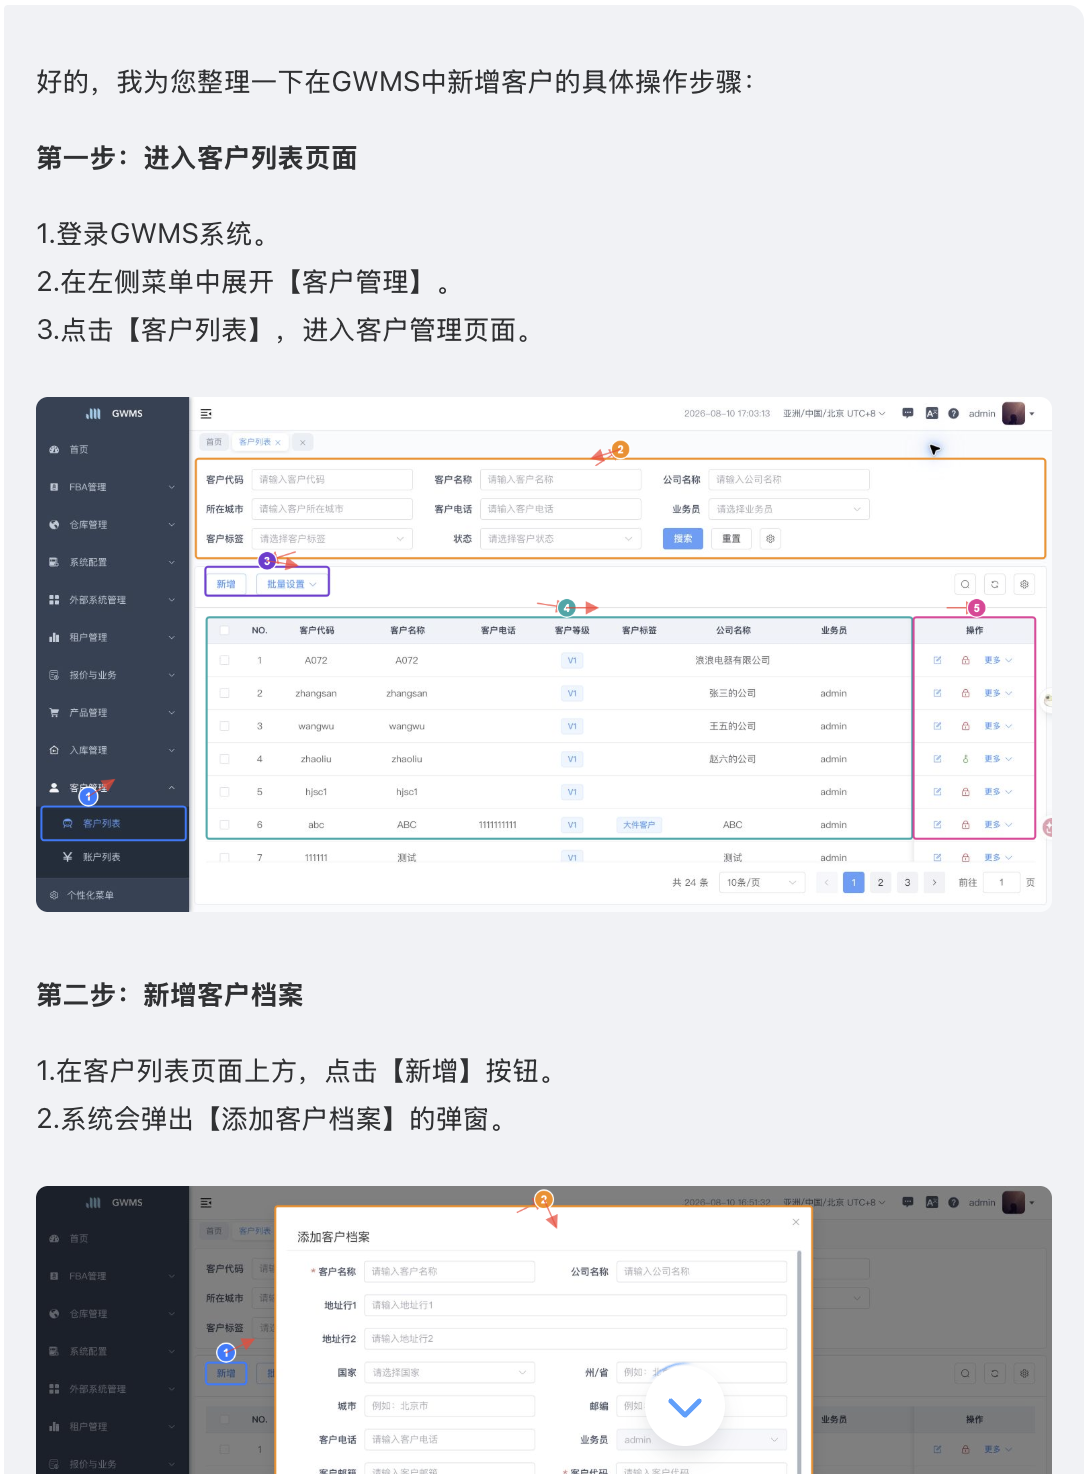
Claude Code 实现:
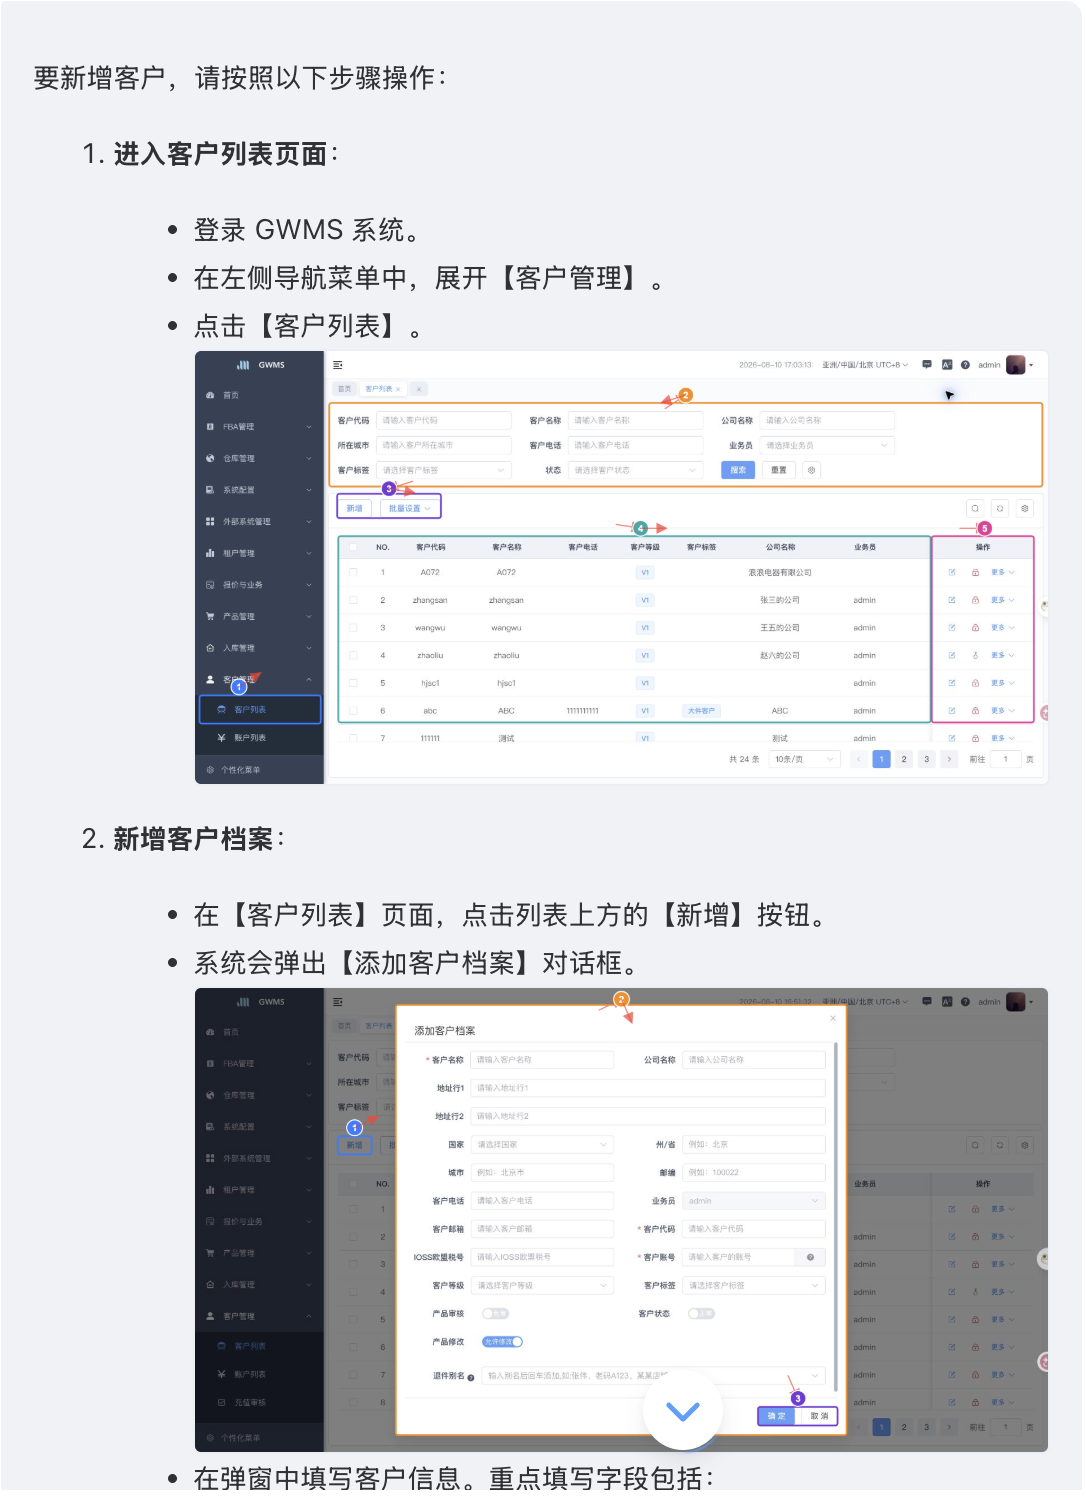
问题二:新增 SKU 如何审核?
DeepSeek Harness 实现:
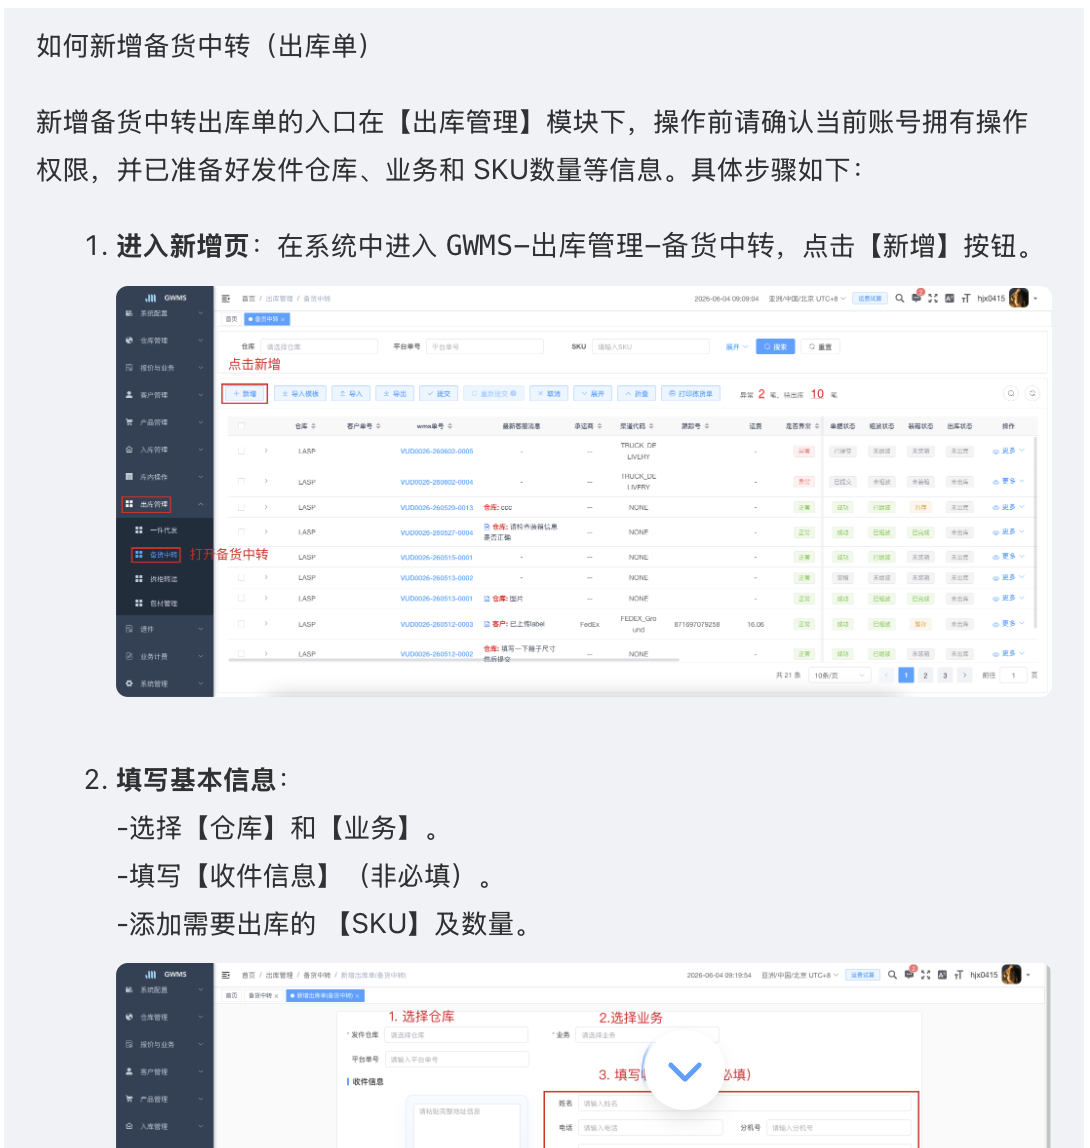
Claude Code 实现:
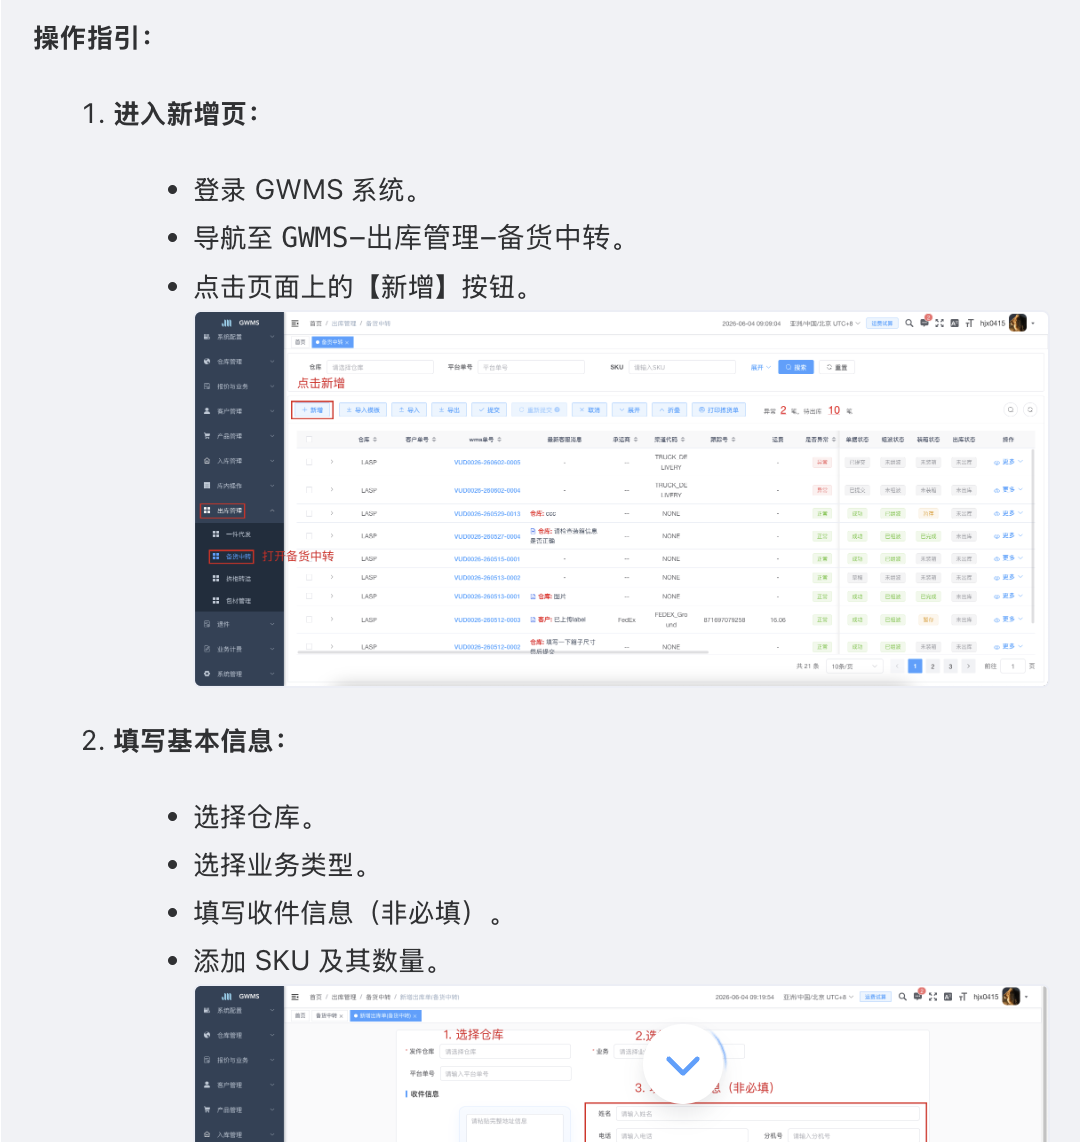
其实区别不大
我要求 DeepSeek Harness 把回答问题的 LLM 也换成 DeepSeek,而 Claude Code 那套仍然用的是 Gemini。至少从这两个简单的问题看,两边效果差别不大。
但实现过程还是留下了很不一样的印象。首先是 DeepSeek Harness 卡死了一次,而且重启也没法恢复;好在我重新开了一个 Session,告诉它「前面的 Session 卡死了」,它就能接上、继续干。另外,DeepSeek Harness 整个 Session 的步骤明显更多、用时也更长,感觉它左左右右探索了很多,最后才锁定方向。
Claude Code CLI 则是直奔主题。我提示了 gwms-doc 这个仓库的存在之后,它很快就和 DeepSeek Harness 追平了认知;几个回合之后,Claude Code 已经达成我的阶段目标了,DeepSeek Harness 还在忙活——很忙。
后来我在 Claude Code CLI 那边又做了几项优化。等 DeepSeek Harness 忙完之后,我把这几项优化一次性提给了它:
检索到的内容中有截图,你可以重新组织语言,但不能把截图给组织没了。
截图的可访问url,可以在https://doc.gwms.jmalltech.com/找到URL地址,AI助手对话框可以引用这些地址显示图片。
图片的尺寸很大,不能直接按原始尺寸显示,得用100%相对宽度。
点击图片,应该全屏查看,再点击就关闭。
DeepSeek Harness 一轮搞定。然后我就问问题、截图。可以说,殊途同归了。
Codex review
我把两边的工作成果交给了 Codex 当裁判:
/Users/jmai/gwms/
这两个repo中有最近两天关于AI助手的变更,Claude做的,提交了3个PR,还有本地没提交的变更。

/Users/jmai/DeepSeekHarness/CTO
这个目录下也有最近两天关于AI助手的变更,全部未提交。

获取两边的变更集合,对比,评价。
Codex 有价值的输出如下:
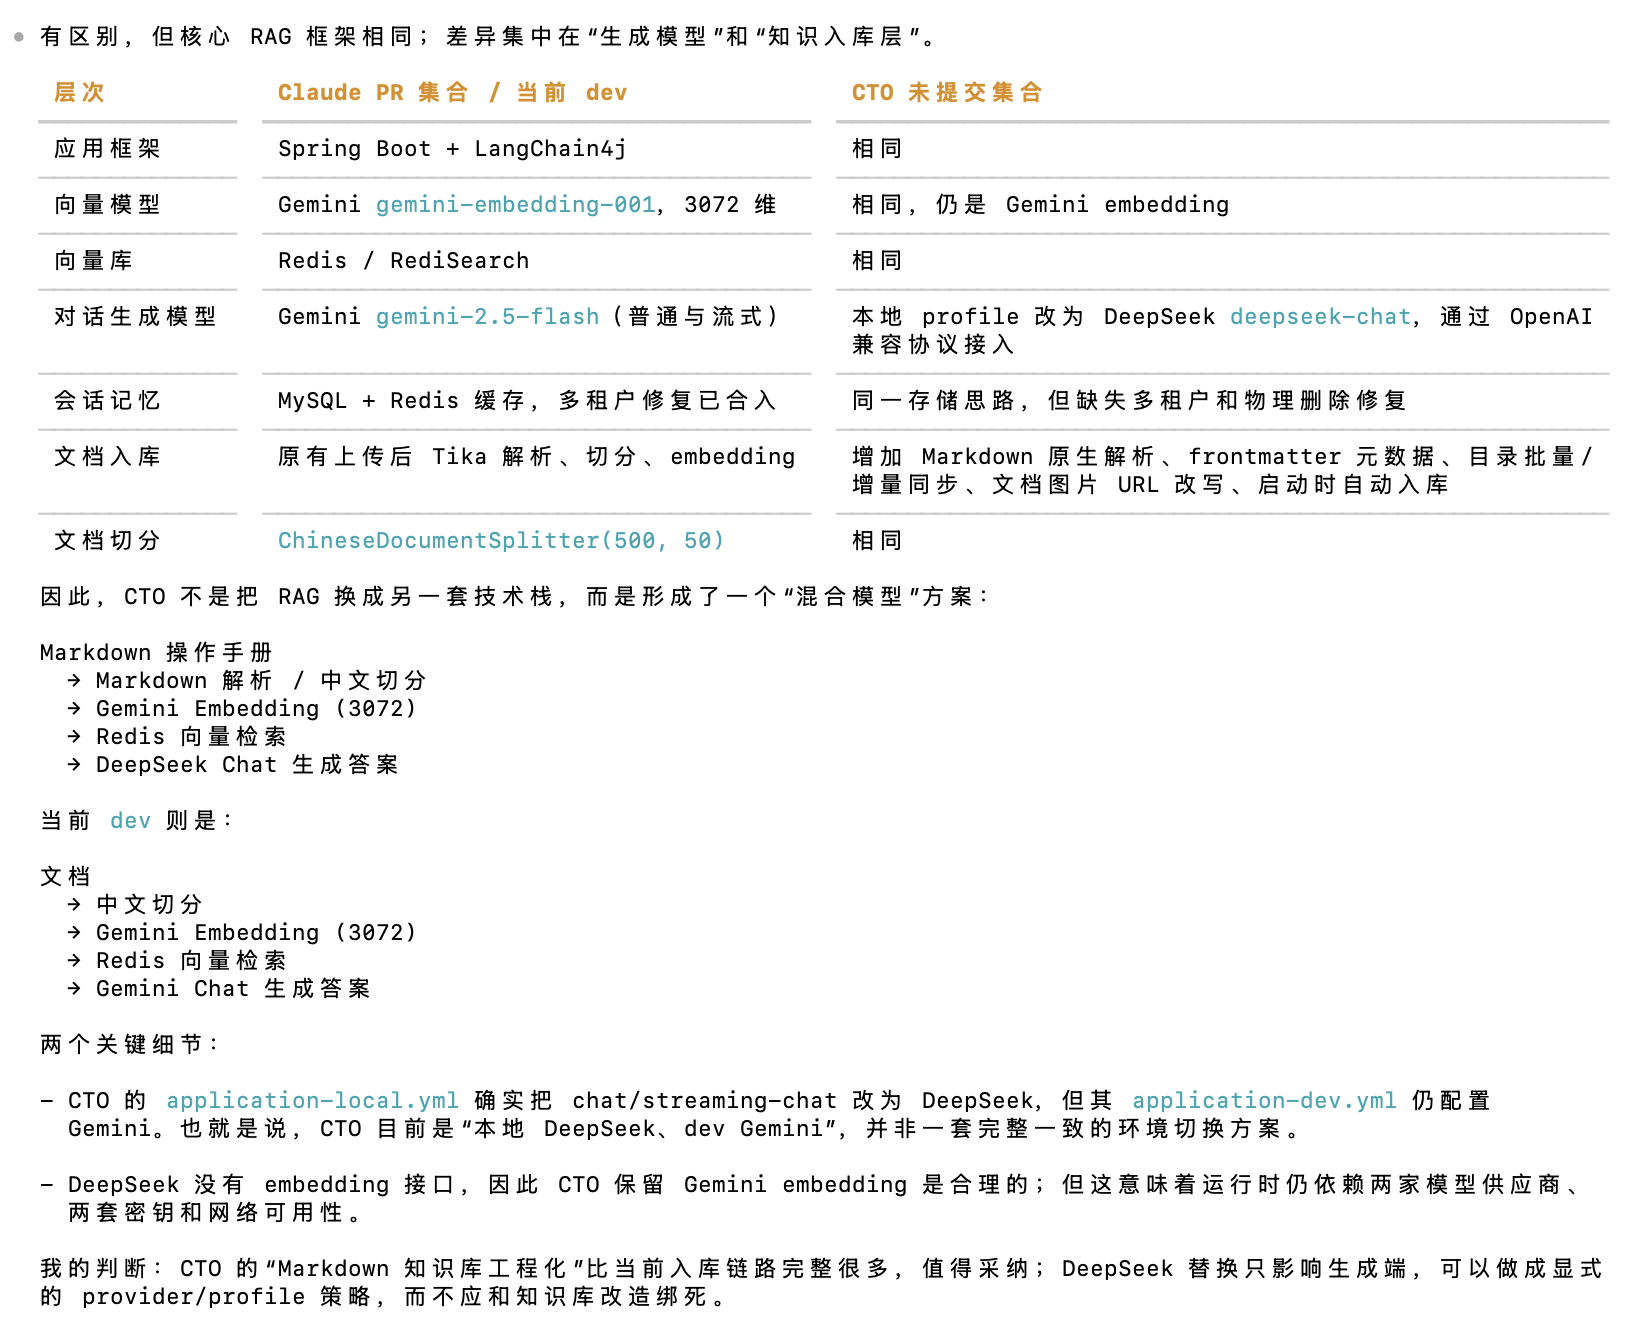
DeepSeek Harness 自主实现了 MarkdownDocumentParser
dev 是 Claude Code 工作空间的代码分支,CTO 是 DeepSeek Harness 的工作目录。
Claude 的实现用 Tika 解析知识库文档;DeepSeek Harness 则自主实现了一个 MarkdownDocumentParser:
.md文件以 UTF-8 直接读取;PDF、Word 等继续用 Tika。- 解析并剥离 YAML frontmatter,避免它进入待 embedding 的正文。
- 提取
title、description、category、role、keywords、related、updated等字段,写入 LangChain4j 的 Metadata。 - 保留 Markdown 的标题、列表、链接与图片语法,后续继续沿用既有的 ChineseDocumentSplitter、Gemini embedding、Redis 向量检索。
这是个加分项,因为 gwms-doc 这个仓库是基于 VitePress 实现的。
---
title: '管理客户档案'
description: '指导仓库在客户列表中查询客户、新增客户、批量设置客户属性,并继续配置客户业务。'
category: '客户管理'
role: '仓库'
keywords: ['客户列表', '客户档案', '客户管理', '批量设置', '业务报价']
related: ['账户列表', '业务报价', '业务报价单']
created: '2026-04-13'
updated: '2026-08-07'
---
上面这段被称作 frontmatter 的东西,是 VitePress 用来解读和展示一个 Markdown 文件的「说明书」。但 Tika 会把这段 frontmatter 直接当成正文,于是出现「检索好像命中了更准的切片,内容却不太匹配」的错位。
以这段为例:
keywords: ['客户列表', '客户档案', '客户管理', '批量设置', '业务报价']如果 Tika 把它当正文,再按 500 字符切分,可能出现:
- 切片 A:
title / description / category / role / keywords / related - 切片 B:正文开头——「客户列表用于维护客户档案……」
- 切片 C:「新增客户」的具体操作步骤……
主要困扰是:
- 用户问「如何新增客户」时,向量检索可能优先命中切片 A,因为那里堆满了关键词,却没有实际操作步骤。
- frontmatter 占用了切片长度和 embedding token;同一个切片能装下的有效业务内容变少,正文标题和步骤更容易被切断。
role: 仓库、category: 客户管理本应是可过滤的 metadata,却退化成模型要去猜含义的普通文本,没法可靠实现「只查仓库端文档」这类过滤。- 模型收到的上下文里可能混着 YAML 配置,于是把
keywords:、related:原样输出,或误把关联文档名当成当前页面的操作步骤。 - 关键词会给 embedding 带来额外权重:比如一篇「客户列表」文档因为同时出现了「业务报价」,可能在「业务报价」相关的问题里被错误召回。
DeepSeek 的原生解析给出了正确的分工:
- 正文 → 切分与 embedding → 交给模型回答
- frontmatter → metadata → 用于过滤、排序、辅助检索
你觉得谁赢了?
其实,我能问出这个问题,在我心里 DeepSeek Harness 已经赢了~~